一、总览
首台 AMD AI 工作站建议用 R9700 32 GB 验证预装。 单用户办公 Agent 跑 7–8B 或 35B Q4,32 GB 已能给权重和上下文缓存留出空间。RX 7900 XTX AI ULTRA 48 GB 适合做高显存选配,重点验证 70B Q4、长上下文和大型生图工作流。需要 CUDA 或更快地处理长文档时,拿原版 RTX 5090 32 GB 做速度基准。
| 型号 | 推理速度 | 板卡规格 | 价格与评分 | |||||
|---|---|---|---|---|---|---|---|---|
| Qwen 35B Q4 生成token/s | Llama 2 7B 生成token/s | 显存GB | 显存带宽GB/s | FP32TFLOPS | 功耗W | 大陆价格 / 预算元 | 规格分/10 | |
| RX 7900 XTX AI ULTRA 48 GBAMD · 供方规格 | 约 95估算依据 | 约 170估算依据 | 48 | 864 | 61 | 约 295 | 20,000–30,000W7900 预算参照 | 9 |
| Radeon AI PRO R9700AMD | 127.4配对实测 | 152.7Vulkan 实测 | 32 | 640 | 47.8 | 300 | 17,899此前优惠 | 8 |
| RTX 5070 TiNVIDIA | 153推测解码实测 | 176.2Vulkan 实测 | 16 | 896 | 43.9 | 300 | 7,102–9,240渠道 | 6 |
| RTX 5090 原版NVIDIA | 194.0配对实测 | 245.5MLPerf 实测 | 32 | 1,792 | 104.8 | 575 | 51,000双宽涡轮 | 8 |
| RTX 5090 D 首版NVIDIA | 约 195估算依据 | 248.2MLPerf 实测 | 32 | 1,792 | 约 105估 | 575 | 47,199–49,499京东卡片 | 8 |
| RTX 5090 D v2NVIDIA | 145–170估算依据 | 214.9MLPerf 实测 | 24 | 1,344 | 约 105估 | 575 | 41,699–48,599京东卡片 | 6 |
| RX 7900 XTX 标准版 24 GBAMD | 104.79独立实测 | 190.9Vulkan 实测 | 24 | 960 | 61.4 | 355 | 7,899此前跟踪 | 6 |
48 GB 比 R9700 多 16 GB,可验证 70B Q4、较大生图流程和多模型驻留。
48 GB 版的速度按 24 GB 标准版和带宽外推,预算参考 W7900 二手约 2 万、新品约 3 万元。
7B 来自 Llama 2 的 MLPerf 或 Vulkan 样本。35B 的配对实测使用相同权重,其余实测的模型、引擎或量化有差异。标有「估算依据」的数字来自实测与规格外推。规格分按显存、带宽与功耗计算,价格为 11 月 20 日汇总。 查看生成速度的测试条件与出处。
规格分是本调研对 35B Q4 单卡驻留、显存带宽与整机功耗 的判断。显存占 4 分,16/24/≥32 GB 分别给 1/2/4 分。带宽占 3 分,低于 800/达到 800/达到 1,200 GB/s 分别给 1/2/3 分。功耗占 3 分,≤320/321–400/>400 W 分别给 3/2/1 分。48 GB 的额外容量在 70B 场景评价。样卡稳定性、实测速度和报价单独影响采购顺序,AI ULTRA 的 9 分是按规格书预评。跑分条件及市场样本见下文。
二、型号与规格
(一)48 GB 板卡的身份
规格书列出 AMD RDNA 3、96 个计算单元、48 GB GDDR6、384 位总线、864 GB/s 带宽、PCIe 4.0 ×16,整板约 295 W。板卡为双槽涡轮、双 8-pin,尺寸为 281 × 111 × 40 mm。规格书标注 ECC,启用方式和可读出的错误计数待样机核对。供方还需明确板卡制造方、料号和支持的 VBIOS、驱动及保修。AMD 官网的 RX 7900 XTX 标准版是 24 GB/960 GB/s/355 W,另有独立产品 Radeon PRO W7900 48 GB/864 GB/s/295 W。三者按完整型号识别。 AI ULTRA 原始规格书 · AMD RX 7900 XTX · AMD Radeon PRO W7900
AI ULTRA 比 R9700 多 16 GB 显存、多 35% 显存带宽,比标准 24 GB 版多一倍显存、带宽低 10%。显存带宽是 GPU 访问板载显存的峰值,模型全驻留时直接关联显卡处理权重和缓存的开销。PCIe 是显卡与主机的链路,更多影响加载和在 CPU、GPU 间频繁搬运数据。带宽占比也受模型结构、算子实现和批量大小影响。 AMD R9700 · 主机与设备传输指南
(二)三款 5090 的差异
- 原版 RTX 5090 32 GB。512 位,1,792 GB/s,575 W,NVIDIA 标称 3,352 AI TOPS。它是本专项的速度参照,有可核对的 35B Q4 配对数据。 NVIDIA RTX 5090 · Blackwell 架构白皮书
- RTX 5090 D 首版 32 GB。NVIDIA 首发资料确认 21,760 CUDA 核心、512 位对应 1,792 GB/s,与原版同容量。表中约 105 TFLOPS 采用万丽 2.407 GHz 的非超频板卡规格,按核心数 × 加速频率 × 2 估算,575 W 同样来自该板卡。相同显存和核心数仍需用目标工作负载验证性能。 NVIDIA 首版 5090 D 发布资料 · 万丽 5090 D 32 GB
- RTX 5090 D v2 24 GB。21,760 CUDA 核心、384 位、1,344 GB/s、575 W、2,375 AI TOPS。比首版 D 少 8 GB 显存和 25% 带宽。表中约 105 TFLOPS 按同一公式及官方 2.41 GHz 估算。它可以作为 CUDA 24 GB 的候选,特别要用实际输入长度和并发检查显存余量。 NVIDIA RTX 5090 D v2
(三)算力与量化口径
FP32 是向量计算峰值。AI ULTRA 规格书另列 FP16 123 TFLOPS,算子和累加精度未注明。R9700 官方列 191 TFLOPS 稠密 FP16 矩阵、383 TFLOPS 稠密 FP8 矩阵。NVIDIA 白皮书列原版 5090/5070 Ti 的 BF16 稠密矩阵、FP32 累加为 209.5/87.9 TFLOPS。AI TOPS、BF16、FP16 和 GGUF Q4 实际生成速度要各自使用匹配的口径。Q4 是权重配方,计算内核和 KV 缓存可以采用其他精度。 AMD R9700 计算规格 · NVIDIA Blackwell 白皮书表 3 与表 5 · llama.cpp 量化文档
三、公开实测与性能
(一)7B 和 35B 推理
- 7B Q4_0。 llama.cpp Vulkan 的 Llama 2 7B tg128 样本中,原版 5090 为 273.7、标准版 7900 XTX 为 190.9、5070 Ti 为 176.2、R9700 为 152.7 token/s。各条记录的系统和软件构建不同。总览的三张 5090 采用 MLPerf 实测,便于横向参照,具体测试见下文。对办公 Agent,输出速度还要结合预填充、工具往返和任务完成时间。 llama.cpp 7B Vulkan 跑分
- 35B Q4。 Qwen3.5-35B-A3B 同一份 UD-Q4_K_XL 和同一 llama.cpp commit 的配对记录里,5090 走 CUDA,R9700 走 Vulkan,均全显存,主机不同。生成均值 194.0 对 127.4 token/s,5090 是 1.52 倍。32K 输入的预填充 6,461 对 1,877 token/s,5090 是 3.44 倍。24 GB 标准 7900 XTX 的 104.79 token/s 来自独立的 Q4_0 混合配方,主要证明这一配置可运行。AI ULTRA 仍缺实卡生成速度,两款 D 的证据见本节下文。 35B 配对原始记录 · 24 GB 7900 XTX 测试记录
- 显存门槛。 上述 35B 两个 Q4 权重为 18.3/19.8 GiB,装好权重还要计入 KV 缓存和运行开销。16 GB 要改量化或卸载,24 GB 可验证全驻留,32 GB 更适合长文档和多轮工具调用。Llama 3.3 70B Q4_K_M 仅权重为 42.5 GB(约 39.6 GiB),48 GB 有机会全驻留,目标上下文与并发要实测。35B 原始 BF16 权重约 67 GiB,需更大显存方案。 35B 权重体积 · 70B Q4_K_M 文件 · 35B BF16 权重索引
(二)生图、图形与训练
生图和渲染要各测自己的工作流。 Puget 同组 Blender Benchmark 中,R9700 为 3,726,普通 24 GB 7900 XTX 为 4,941,5070 Ti 为 7,882,原版 5090 为 15,872。索泰两款 D 的《黑神话:悟空》4K 样本,首版 D 98 FPS、D v2 95 FPS,使用影视画质和 TSR 50%,来自同媒体不同时间的测试。两组数据分别回答渲染和游戏表现。AI ULTRA 的确切成绩待样卡测试。 Puget 渲染测试 · 索泰两款 D 的图形与游戏实测
生图预装以实际 ComfyUI 节点和模型做验收,测生成时间、峰值显存、工作流成功率。训练验证从项目确实需要的 LoRA 或 QLoRA 开始,固定模型、有效批量、分辨率或序列长度、精度和步数。AMD 的 Windows 与 Linux 支持矩阵列有 R9700、标准 RX 7900 XTX 和 Radeon PRO W7900,AI ULTRA 48 GB 需按实机识别和项目依赖验证。NVIDIA 50 系也须核对 Blackwell 支持的 CUDA、PyTorch 构建和扩展版本。 ROCm Windows · ROCm Linux · Blackwell 软件迁移指南
(三)生成速度的实测与估算依据
两款 5090 D 的 7B 实测。 《微型计算机》用 MLPerf Client v0.5 测 Llama 2 7B,首版 D 综合生成 248.24 token/s,四个任务为 233.56–262.32。iXBT 的 Llama 2 7B DirectML 同组评测中,D v2 214.9、原版 5090 245.5 token/s,D v2 约为原版的 87.5%。首版 D 来自另一家评测,主机和统计方式有差异。七彩虹 D v2 在另一个 Procyon DirectML v1.0.82 测试中,Mistral 7B 生成 228.88 token/s,Llama 3.1 8B 为 188.97 token/s。 首版 D 原始评测 · 首版 D 原始图表 · iXBT D v2 原始评测 · iXBT 原始图表 · 七彩虹 D v2 原始评测
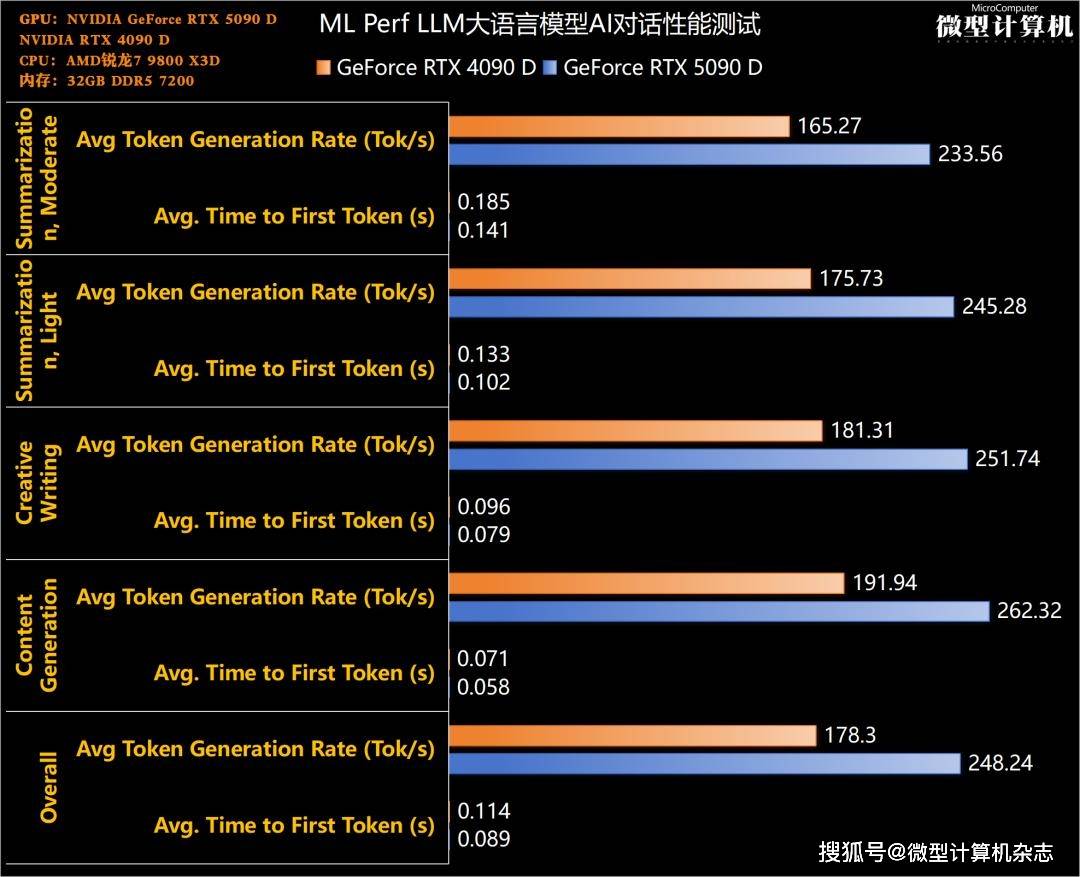

主表估算针对单路、模型全显存驻留的生成阶段。估算值按约 5 token/s 的粒度显示,供选型参考。不同权重、上下文、引擎和卸载方式会改变吞吐,区间代表两种外推情景。
- 5090 D 首版 35B Q4,约 195。 以原版 5090 的 194.0 为基准,按两卡同为 1,792 GB/s 的显存带宽外推。首版 D 的 7B 实测接近其他评测的原版速度,可核对量级。其 35B 自报数据见下文。 35B 实测基准 · 首版 D 规格
- 5090 D v2 35B Q4,约 145–170。 以原版 194.0 为基准,按两卡显存带宽比 1,344/1,792 外推为 145.5,按 iXBT 的 7B 实测比 214.9/245.5 外推为 169.8。第二种情景跨模型,外部对 Qwen3.6 的估算另见下文。 D v2 官方规格 · iXBT 原始图表 · 35B 实测基准
- 7900 XTX AI ULTRA 48 GB,35B 约 95、7B 约 170。 以标准 24 GB 版同架构的 104.79(Qwen3.5 35B,混合 Q4_0)和 190.92(Llama 2 7B Q4_0)乘以显存带宽比 864/960,得到 94.3/171.8。48 GB 版的驱动、VBIOS 和频率需按实卡核对。 AI ULTRA 规格书 · 标准版规格 · 35B 实测基准 · 7B 实测基准
其他 35B 记录与交叉参考
- RTX 5090 D 首版 32 GB。 有作者自报 35B MoE 生成 196.77 token/s,称采用 Q4、
-ngl 99、实测显存 30.7 GB。文章未给实际 GGUF 或原始日志,且注明的 llama.cpp b4474 发布于 2025 年 1 月,早于文中示例模型 Qwen3.6。另有上游 issue 确认 5090 D 实机加载过 Qwen3.5-35B-A3B-Q4_K_M,记录的是多模态错误,未报告生成速度。 作者记录 · b4474 发布记录 · llama.cpp 实机记录 - RTX 5090 D v2 24 GB。 VRAMGlass 对 Qwen3.6 35B 的 4-bit 档给出 162.6 token/s,GPU TPS 对该模型的 Q4_K_M 给出 208 token/s。这是两套外部估算。GitHub 有该卡的其他模型实机记录,PolyStrata 的 GLM 5.3 Flash 3-bit 约 26–30 token/s,Xolotl 的 DeepSeek V4.1 Flash 主存卸载实测约 15.0–17.7 token/s(锁页、不开推测解码),对应工作负载远大于 35B。 VRAMGlass 估算 · GPU TPS 估算 · PolyStrata 实机记录 · Xolotl 实机日志
- RTX 5070 Ti 补充实测。 PolyStrata 0.1.45 跑 Qwen3.6-35B-A3B UD-Q4_K_M,32K 配置并开启推测解码,作者记录短对话 164 token/s、Agent 会话 153 token/s。这台机器有 63.9 GiB 系统内存,记录未披露全显存驻留。表中这个数值与 R9700 的 127.4 来自不同引擎和解码路径,无法据此排序。 PolyStrata 原始测试
- 原版 RTX 5090 的 Qwen3.6 实测。 独立数据集记录 UD-Q4_K_M、llama.cpp CUDA 的 tg128 为 270.97 token/s。另一位作者用 vLLM 与 NVFP4,在 192K 上下文配置下自报交互生成约 145 token/s,各次请求长度不同。主表保留 Qwen3.5 的 194.0,对应与 R9700 使用同一权重的对照。 llama.cpp 实测数据集 · NVFP4 配置与记录
同口径比较需要锁定 GGUF 文件版本、llama.cpp 构建、KV 精度、上下文与卸载设置。Unsloth 后来修订过早期配对使用的同名权重,两版文件体积和量化配方不同。24 GB 卡尤其要同时记录 GPU 卸载层数、实际输入长度和峰值显存。 Unsloth 权重修订
四、价格、供货与整机成本
- 三款 5090 的价格要锁到具体板卡。 截至 2026 年 11 月 20 日,航业算力页面显示原版 32 GB 双宽单涡轮 ¥51,000。同一个京东页面可见的相关商品卡片里,原版华硕 TUF 为 ¥52,199、FE 公版卡片 ¥52,599,首版 D 32 GB 技嘉风魔 ¥47,199、华硕 TUF ¥49,499,D v2 24 GB 技嘉魔鹰 ¥41,699、超级雕 ¥48,599。这些是不同板卡的公开单点,库存、票税和保修待复核。NVIDIA 首版 D 首发建议价 ¥16,499,D v2 官网也列 ¥16,499 起。指导价看产品定价,当前采购按指定型号的可结算报价判断。 同页京东商品样本 · 原版 5090 双宽渠道样本 · 首版 D 建议价 · D v2 官网
- R9700 与 24 GB 标准版。 盈通 R9700 WA 京东快照标价 ¥17,999,优惠后 ¥17,899.01。标准 7900 XTX 的 ¥7,899 为此前零售跟踪样本。5070 Ti 的 ¥7,102 和 ¥9,240 分别来自两款渠道卡。R9700 的差价主要换来 35B Q4 的显存驻留和上下文余量,实际采购按同时间的价格和保修比较。 盈通 WA 京东商品 · 5070 Ti 猎鹰 · 5070 Ti 追风 OC
- 48 GB 预算参照。 Radeon PRO W7900 二手约 ¥20,000,新品约 ¥30,000。此前二手跟踪样本约 ¥22,000,京东双槽和三槽商品页均显示 W7900,2024 年促销记录约 ¥33,264。AI ULTRA 的总览沿用这个同容量预算参照,京东商品型号为 W7900。比较这笔预算是否值得,先看工作流能否实际用到 32 GB 以上。 二手行情 · 京东双槽版 · 京东三槽版 · 京东历史促销记录
- 美国定价参照。 厂商公布的美元建议价为 RTX 5090 $1,999、R9700 $1,299、RTX 5070 Ti $749。这些是历史定价资料,现货与到手价另计。 NVIDIA RTX 50 系列首发公告 · AMD R9700 建议价
- 整机看功耗等级和机箱。 AI ULTRA 约 295 W,规格书建议至少 750 W 电源。5090 原版和 D 系列是 575 W 级,按板卡匹配电源、线材、风道及机箱。用标称板卡功耗差 280 W 做情景估算,每年按高负载 1,000 小时折算,相差约 280 kWh,实际电费以整机插座实测和使用时间核算。报价单写明料号、新旧状态、含税交付、退换、保修、交期及整机电源和散热费用。 AI ULTRA 原始规格书 · RTX 5090 系统功耗要求
五、场景选型与样机验收
- 办公 Agent 主配置用 R9700 32 GB 起步。 面向要跑本地模型、长文档和多轮工具调用的个人工作站用户。按交付镜像验证 7–8B 和 35B Q4,固定权重哈希、8K 与 32K 输入、KV 精度和并发,记录首 token、生成、端到端任务时长及峰值显存
- AI ULTRA 48 GB 放在高显存选配。 面向要跑 70B Q4、较大生图工作流或模型常驻的用户。取得板卡料号与支持说明后,用目标软件实占超过 32 GB 并长时运行,核对 VBIOS、驱动、ECC、重启恢复、温度及噪声。如果核心工作流能稳定留在 32 GB 内,按已测速度和整机价格选
- CUDA 和速度优先时分开询三款 5090。 原版 5090 做上限参照。首版 D 32 GB 可验证 32 GB CUDA 配置,按任务完成时间和含税交付价决定。D v2 24 GB 只在目标任务通过 24 GB 峰值测试时进入候选。显存更轻的 7–8B、游戏或中小型 CUDA 工作流可先看 5070 Ti
六、参考资料
- AMD 与 NVIDIA 的产品规格、Blackwell 白皮书和板卡厂商资料用于核对型号、容量、带宽、功耗、精度和建议价,各主张就近标出对应原文
- 第三节逐项链接 llama.cpp、MLPerf、Procyon、PolyStrata 和其他原始测试。35B 的估算公式、外部估算和自报记录均注明适用条件
- 原始 48 GB 规格书及此前市场、跑分资料随专项归档。 AI ULTRA 规格书 · 独立显卡来源记录 · R9700 对标调研